


O wie Datenbank
Johannes Ahrends, Robert Marz, Oliver Pyka
Oracle und Unicode: Raus aus der 8-Bit-Welt
OCT 6, 202618 MIN
Description
Warum Datenbanken mit Ein-Byte-Zeichensatz ein Ablaufdatum haben, was bei der Umstellung auf AL32UTF8 schiefgehen kann und wie Johannes seine Kunden durch das Projekt führt.
Oracle und Unicode: Raus aus der 8-Bit-Welt
Eine Zeichensatz-Migration ist ein Projekt, kein Schalter
Johannes steigt diesmal mit einer Frage aus aktuellem Anlass ein: Gibt es in Roberts Projekten noch Datenbanken mit einem Ein-Byte-Zeichensatz? Gibt es, und zwar reichlich. Datenbanken, die vor zwanzig Jahren aufgesetzt und seitdem immer wieder migriert wurden, ohne dass jemand den Zeichensatz angefasst hätte. Manche davon laufen bis heute mit WE8ISO8859P1, dem Zeichensatz ohne Eurozeichen. Johannes betreut gerade eine Unicode-Migration, die nach zwei Jahren noch nicht abgeschlossen ist, und will wissen, was dabei alles zu beachten ist.
Zunächst die Grundlagen: Oracle 6 und 7 wurden standardmäßig mit US7ASCII installiert, 7 Bit, 128 Zeichen. Das achte Bit wurde für Umlaute zweckentfremdet, war aber nicht supported. Danach kam die Zeit der standardisierten Ein-Byte-Zeichensätze: MSWIN1252 auf Windows, in der Oracle-Datenbank WE8ISO8859P1 ohne und WE8ISO8859P15 mit Eurozeichen. Westeuropa war damit abgedeckt, aber nur westeuropäisch: Das Gravis-Zeichen aus offiziellen Dokumenten fehlt im ISO-Zeichensatz, nordische Umlaute ebenso. Die Oracle-Datenbank kennt dazu einen zweiten Zeichensatz, den National Character Set für NCHAR, NVARCHAR und NCLOB. Johannes nennt ihn einen Exoten, der die Migration nur komplexer macht.
Der Standard für neue Datenbanken ist AL32UTF8, ein Zeichensatz mit variabler Breite von einem bis vier Byte pro Zeichen. A bis Z brauchen ein Byte, Umlaute zwei, das Eurozeichen drei. Damit beginnt das eigentliche Problem: VARCHAR2(50) bedeutet standardmäßig 50 Byte, nicht 50 Zeichen. Nach der Umstellung passen Namen mit Umlauten nicht mehr in die Spalte, und abgeschnittene Namen will niemand. Die Antwort heißt Längensemantik CHAR, also VARCHAR2(50 CHAR). Der Parameter NLS_LENGTH_SEMANTICS könnte das zum Default machen, Oracle rät aber davon ab, ihn auf Instanzebene zu setzen: Das Data Dictionary bleibt ein Ein-Byte-Zeichensatz, und beim Patchen muss der Parameter wieder zurückgedreht werden. Johannes' Empfehlung: von Anfang an mit CHAR-Semantik arbeiten und den Parameter per ALTER SESSION setzen.
Vor der Migration steht der Scan mit dem DMU, dem Database Migration Assistant for Unicode. Das kostenlose Tool von Oracle findet Sonderzeichen, Längenprobleme und Spalten am 4000-Byte-Limit von VARCHAR2, und zwar nicht auf der Produktion, sondern auf einem Backup oder einer Standby-Datenbank. Migriert wird dann per Export und Import in eine neue Datenbank mit AL32UTF8. Das dauert bei Terabyte-Datenbanken Stunden bis Tage und ist komplett offline. Die In-Place-Konvertierung hat Johannes noch nie gemacht, weil ihm Strukturänderungen auf Produktionsdaten zu gefährlich sind.
Robert bringt MAX_STRING_SIZE=EXTENDED ins Spiel, mit dem VARCHAR2 bis 32K groß werden darf. Der Pferdefuß: Ab etwa 4000 Byte speichert Oracle den Wert intern als LOB, also out of line, mit anderer Performance und einer Tabellengröße, die nicht mehr die ganze Wahrheit zeigt. Dazu kommt, dass CLOBs nach der Umstellung doppelt so groß werden, weil sie nicht in AL32UTF8, sondern in UCS-2 mit mindestens zwei Byte pro Zeichen gespeichert sind. Das kostet Platz, Buffer Cache und Performance und muss eingeplant werden. Ein Grund, bei 8 Bit zu bleiben, ist das trotzdem nicht: Java und praktisch alle Anwendungen setzen UTF-8 voraus.
Aus seinem laufenden Projekt berichtet Johannes, warum zwei Jahre vergehen können: viele abhängige Systeme und Datenbanken, die mit umgestellt werden müssen, und die Frage, wie sich die Downtime bei einer großen Datenbank reduzieren lässt. Der Kunde setzt eine Replikationslösung ein, die Änderungen während der Migrationsphase aus der alten in die neue Datenbank überträgt, GoldenGate oder Quest SharePlex. Eine eigene Folge zur Replikation ist damit ausgemacht. Zum Schluss der Klassiker falsch kodierter Altdaten: Ein Client, der der Datenbank sagt, sie brauche nicht zu konvertieren, speichert ein Ü als etwas völlig anderes ab und bekommt es auch so zurück. Garbage in, garbage out. Bei der Migration fällt das auf und muss in der Regel von Hand bereinigt werden. Das Fazit der beiden: 8-Bit-Datenbanken migrieren, neue Datenbanken nur noch mit AL32UTF8 anlegen, und die Umstellung als Projekt aufsetzen.
Diese Folge in der Übersicht:
Viele gewachsene Datenbanken laufen noch mit Ein-Byte-Zeichensätzen wie WE8ISO8859P1 oder WE8ISO8859P15, weil nie Druck zur Umstellung bestand.
Historie: US7ASCII bei Oracle 6 und 7, danach MSWIN1252 und die ISO-8859-Familie. Gravis und nordische Umlaute fehlen im westeuropäischen Repertoire.
Der National Character Set für NCHAR, NVARCHAR und NCLOB ist ein Exot, der die Migration nur komplexer macht.
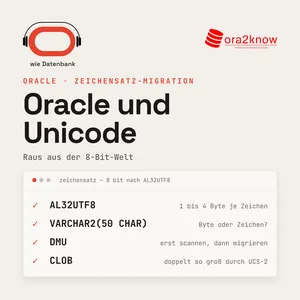
AL32UTF8 ist der Standard für neue Datenbanken: ein bis vier Byte pro Zeichen, Umlaute zwei, Eurozeichen drei.
VARCHAR2(50) bedeutet 50 Byte. Für Unicode braucht es die Längensemantik CHAR, also VARCHAR2(50 CHAR).
NLS_LENGTH_SEMANTICS nicht auf Instanzebene setzen, sondern per ALTER SESSION: Das Data Dictionary bleibt Ein-Byte, beim Patchen muss der Parameter zurück.
Der DMU (Database Migration Assistant for Unicode) scannt die Datenbank vorab, kostenlos und mit grafischer Oberfläche. Scan nur auf Kopie, Backup oder Standby.
Standardweg: Export und Import in eine neue AL32UTF8-Datenbank, komplett offline, bei Terabyte-Datenbanken Stunden bis Tage.
MAX_STRING_SIZE=EXTENDED erlaubt VARCHAR2 bis 32K, speichert ab etwa 4000 Byte aber intern als LOB.
CLOBs werden nach der Umstellung doppelt so groß, weil sie in UCS-2 mit mindestens zwei Byte pro Zeichen abgelegt werden.
Downtime reduzieren: Replikation mit GoldenGate oder Quest SharePlex während der Migrationsphase.
Falsch kodierte Altdaten (Garbage in, garbage out) fallen erst bei der Migration auf und müssen meist von Hand bereinigt werden.
Weiterführende Links und Ressourcen:
ora2know Website
Oracle Database Migration Assistant for Unicode (DMU) (Download und Produktseite)
DMU Dokumentation (Oracle Docs)
Choosing a Character Set (Database Globalization Support Guide)
NLS_LENGTH_SEMANTICS (Database Reference)
MAX_STRING_SIZE (Database Reference)
Oracle GoldenGate (Oracle)
Quest SharePlex (Quest)
Folge 1: Oracle Database 26ai ist da (Migration als Gelegenheit für den Zeichensatzwechsel)
Folge 9: Oracle und JSON (JSON ist UTF-8, noch ein Grund für Unicode)
Nützliche Befehle:
-- Zeichensätze der Datenbank anzeigen
SELECT parameter, value
FROM nls_database_parameters
WHERE parameter IN ('NLS_CHARACTERSET', 'NLS_NCHAR_CHARACTERSET', 'NLS_LENGTH_SEMANTICS');
-- Längensemantik CHAR für die aktuelle Session (nicht auf Instanzebene setzen)
ALTER SESSION SET NLS_LENGTH_SEMANTICS = CHAR;
-- Spalte explizit mit Zeichensemantik anlegen
CREATE TABLE kunden (name VARCHAR2(50 CHAR));
-- Byte- und Zeichenlänge eines Werts vergleichen
SELECT name, LENGTH(name) AS zeichen, LENGTHB(name) AS bytes FROM kunden;
Die Podcast-Hosts und Director:
Johannes Ahrends: Oracle ACE, DBA, ora2know. Web: carajandb.com
Robert Marz: Oracle ACE, IT-Architect, ora2know. Web: robbie.databee.org
Oliver Pyka: Oracle ACE, Freiberufler, ora2know. Web: pyka.de
Über O wie Datenbank:
Der deutschsprachige Oracle-Datenbank-Podcast von ora2know. Johannes Ahrends, Robert Marz und Oliver Pyka bringen zusammen über 90 Jahre Oracle-Erfahrung mit und sprechen an jedem ersten und dritten Dienstag im Monat über das, was DBAs, Entwickler und IT-Entscheider wirklich bewegt: Migration, Architektur, neue Features, Betrieb und Strategie rund um die Oracle Datenbank. Praxisnah, meinungsstark und ohne Marketing-Sprech.
Über ora2know:
Wissen teilen, Netzwerk aufbauen. ora2know ist eine unabhängige Community für Oracle-Datenbank-Administratoren und -Entwickler im deutschsprachigen Raum. Unser Ziel ist der praxisnahe Austausch von Wissen und Erfahrungen rund um Oracle Database, Oracle APEX und Oracle AI. Ohne kommerzielle Interessen, getragen von Enthusiasmus und gegenseitiger Hilfe. Ob DBA, Entwickler oder Architekt: ora2know verbindet Oracle-Profis in Deutschland, Österreich und der Schweiz.
Über diese Podcast-Produktion:
Diese Folge ist eine Eigenproduktion von ora2know.